RAG: Cómo Darle "Visión Semántica" a tu Inteligencia Artificial
El problema de la "alucinación"
Integrar un asistente de Inteligencia Artificial en tu negocio suena genial, hasta que le hacen una pregunta específica sobre tus políticas de devolución y el bot, en lugar de decir "no sé", inventa una respuesta que no tiene nada que ver con la realidad. A esto se le llama "alucinación".
El problema es que los Modelos de Lenguaje (LLMs) como ChatGPT vienen pre-entrenados con información general de internet, pero por defecto no tienen acceso a los datos privados de tu empresa.
Para solucionar esto, en la ingeniería de IA utilizamos una arquitectura llamada RAG (Retrieval-Augmented Generation, o Generación Aumentada por Recuperación). Para entender cómo funciona, imaginá que le damos a la IA un visor cyborg de última generación.
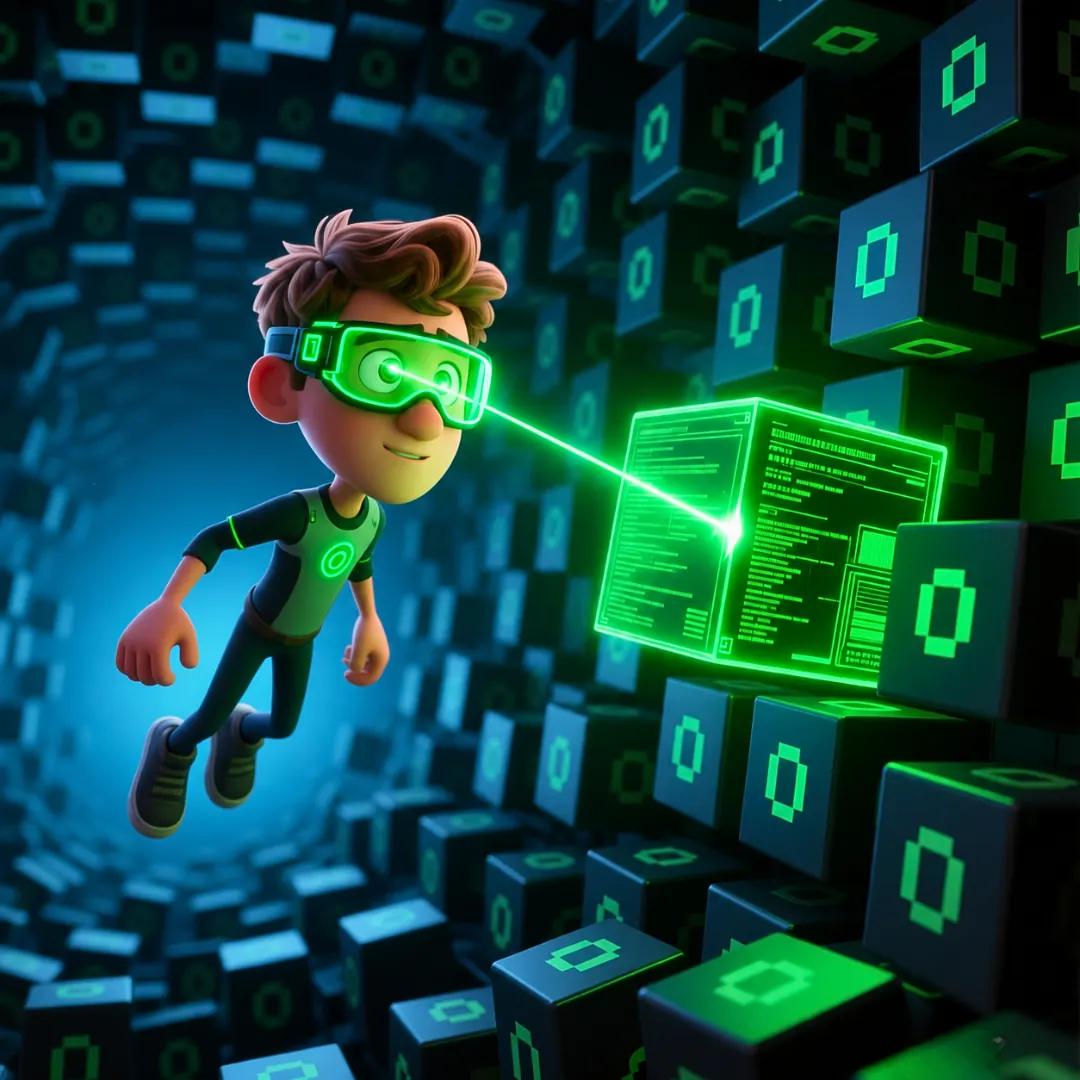 RAG busca por significado (semántica), iluminando el documento correcto aunque no use las palabras exactas de la búsqueda.
El problema de la búsqueda tradicional
Si usás un buscador tradicional en tu base de datos y escribís "acuerdo de alquiler", el sistema busca exactamente esas palabras. Si tu documento dice "contrato de arrendamiento", el buscador probablemente no lo encuentre. Es una búsqueda literal y, a menudo, ineficiente.
RAG cambia el juego procesando los documentos, PDFs y manuales de tu empresa y transformándolos en un inmenso océano de datos matemáticos (vectores o embeddings).
El visor cyborg y el láser semántico
Cuando implementamos RAG, le ponemos a la IA un "visor semántico".
Cuando un usuario hace una pregunta, el visor no busca solo letras o palabras clave. Emite un haz de luz que escanea ese océano de datos buscando significado. Si el usuario pregunta por "alquileres", el láser impacta e ilumina el bloque de datos que contiene el "contrato de arrendamiento", porque matemáticamente vibran en una frecuencia semántica similar.
La IA, gracias a este proceso de recuperación, recibe como contexto adicional ese bloque de información específico que acaba de encontrar.
Respuestas precisas, menos inventos
Una vez que el visor recuperó el dato correcto, ocurre la segunda parte de RAG (la Generación).
Le indicamos al modelo en su prompt: "Basándote principalmente en la información de este bloque recuperado, respondé la pregunta del usuario".
Es el equivalente a un examen a libro abierto. La IA ya no tiene que adivinar; el modelo lee el fragmento de tu base de datos y redacta una respuesta natural, fuertemente basada en el contexto real de tu negocio. Si bien RAG no elimina el 100% de las alucinaciones y requiere validación, reduce drásticamente el riesgo de inventar datos.
Construir un asistente virtual verdaderamente útil no se trata de enchufar un modelo genérico. Se trata de darle las herramientas arquitectónicas correctas para que pueda procesar tu información con mucha más claridad.