Cuantización: El Arte de "Comprimir" una IA sin Perder su Esencia
El peso de los grandes modelos
Los grandes modelos de Inteligencia Artificial son obras maestras de la ingeniería, pero tienen un problema: son muy pesados. Su precisión los convierte en archivos gigantescos que requieren hardware muy potente (GPUs con enormes cantidades de memoria VRAM) para poder funcionar a buena velocidad.
Si cada vez que un usuario hace una consulta se necesitaran recursos ilimitados, el costo sería astronómico. ¿Cómo logran las empresas servir a millones de usuarios de forma eficiente? Utilizando una técnica de optimización matemática brillante: la cuantización.
Para entenderla de forma intuitiva, pensemos como escultores.
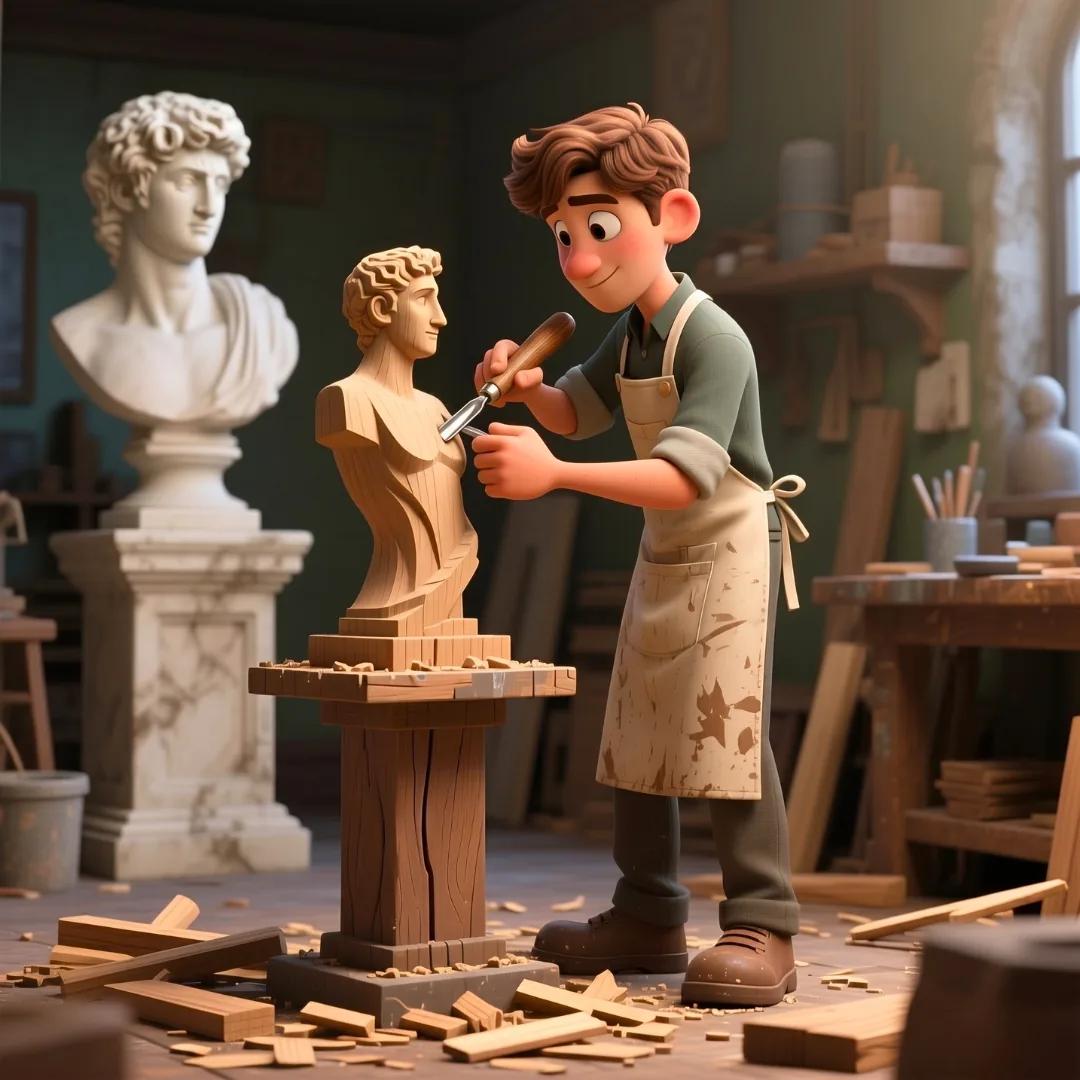 La cuantización comprime el modelo reduciendo la precisión de sus números, haciéndolo mucho más ligero sin perder su capacidad de respuesta.
La estatua de mármol vs. la réplica de madera
Imaginemos que un escultor crea su obra maestra: una estatua de mármol gigante y detallada. Cada pliegue de la ropa está esculpido con precisión. Es una pieza magnífica, pero es tan pesada que solo los museos con grúas especiales pueden moverla.
Para hacerla más accesible, el escultor crea una réplica en un material mucho más ligero, como la madera.
Esta nueva estatua no tiene el detalle microscópico del mármol. El escultor "redondeó" algunas formas. Sin embargo, a simple vista, la esencia está intacta: la pose, la expresión y la forma general son las mismas, pero ahora es muchísimo más ligera.
De la escultura a los números
La cuantización hace conceptualmente lo mismo con los parámetros de un modelo de IA.
Un modelo original (la estatua de mármol) almacena sus "pesos" en números de alta precisión con muchos decimales, como los formatos de coma flotante de 32 bits (FP32) o 16 bits (FP16/BFloat16).
El proceso de cuantización (que puede hacerse post-entrenamiento) simplifica y mapea estos números a formatos de menor precisión (como números enteros de 8 bits o INT8).
Al hacer esto, el resultado es asombroso:
- El tamaño del modelo en memoria VRAM se reduce drásticamente. Esto permite cargar modelos grandes en hardware más accesible o agrupar más usuarios en una misma GPU.
- Con hardware y bibliotecas optimizadas para estas operaciones (como las NPUs modernas), los cálculos se vuelven más rápidos, reduciendo la latencia de respuesta.
Al igual que la estatua de madera, la pérdida de calidad del modelo comprimido suele ser sumamente pequeña frente a las enormes ganancias de eficiencia y reducción de costos operativos.