¿Cómo aprende una IA qué respuestas son mejores?
No alcanza con que una IA sepa escribir
Imaginemos que estamos entrenando un asistente de IA. Le pedimos que explique un concepto y genera dos respuestas: ambas son correctas, pero una es confusa y la otra va al grano, explica lo necesario y se entiende mucho mejor.
¿Cómo hacemos para que el modelo aprenda esa diferencia y no se limite a generar texto gramaticalmente correcto?
Una de las técnicas utilizadas para conseguirlo es RLHF (Reinforcement Learning from Human Feedback). La idea es incorporar evaluaciones humanas al entrenamiento para ajustar las respuestas que genera el modelo.
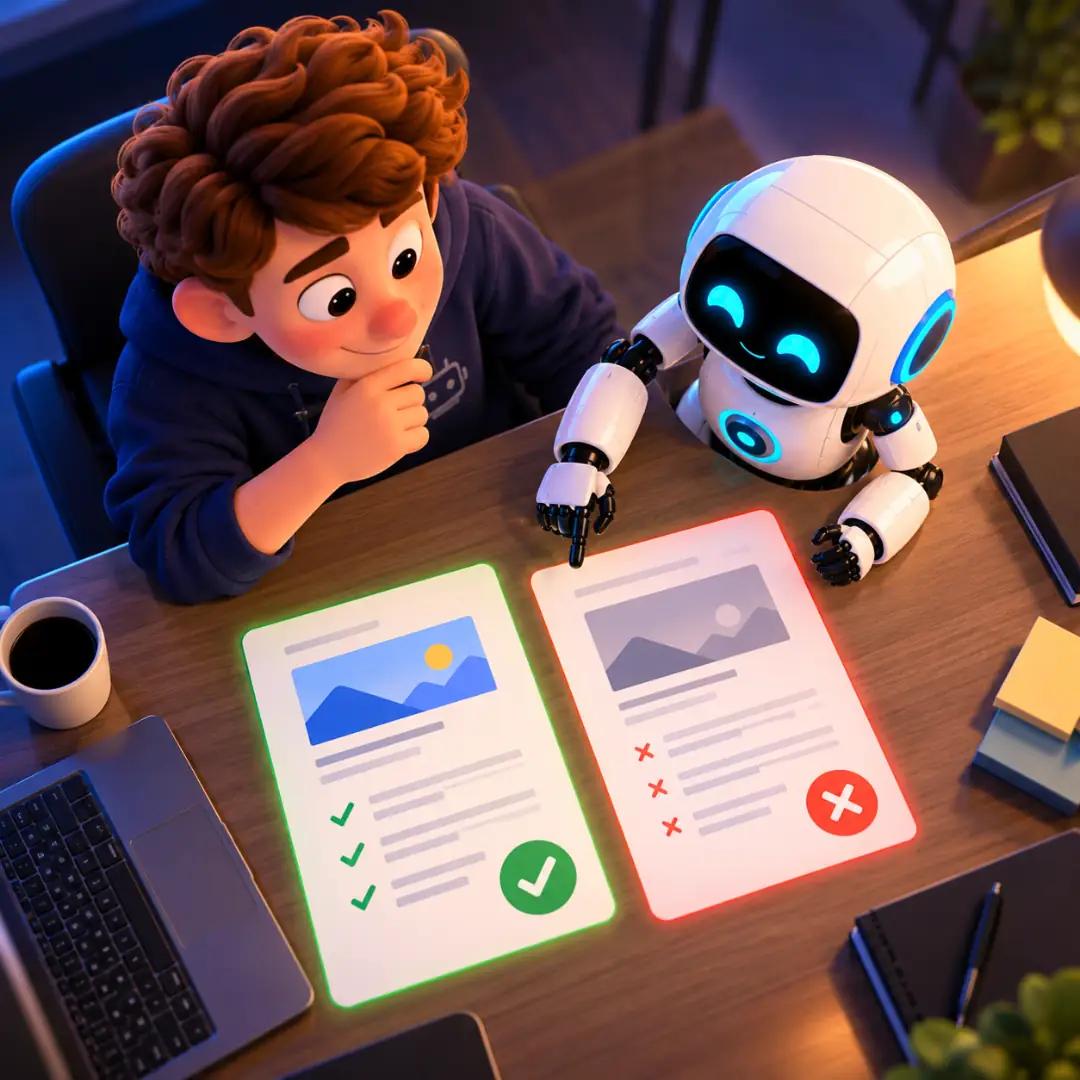 Al comparar dos respuestas, los evaluadores aportan ejemplos de cuáles prefieren. Esas elecciones se utilizan para orientar el entrenamiento.
De comparar respuestas a entrenar un modelo
En el proceso clásico de RLHF, se generan varias respuestas para una misma instrucción y personas encargadas de evaluarlas indican cuál funciona mejor. Esas comparaciones se utilizan para entrenar un modelo de recompensa (Reward Model), que aprende a puntuar nuevas respuestas según los criterios observados.
Así, el sistema puede estimar qué respuestas se acercan más a lo que buscamos sin necesitar que una persona evalúe cada resultado durante el ajuste.
Pero esa puntuación no es una medida de verdad. El modelo de recompensa aprende de las evaluaciones que recibe y puede reproducir sus sesgos o equivocarse al valorar una respuesta.
Cómo se utiliza esa recompensa
Una vez entrenado, el modelo de recompensa sirve para ajustar el modelo de lenguaje mediante aprendizaje por refuerzo. En el enfoque clásico se utiliza, por ejemplo, PPO (Proximal Policy Optimization), un algoritmo que optimiza las recompensas sin permitir que el modelo se aleje demasiado de su comportamiento de referencia.
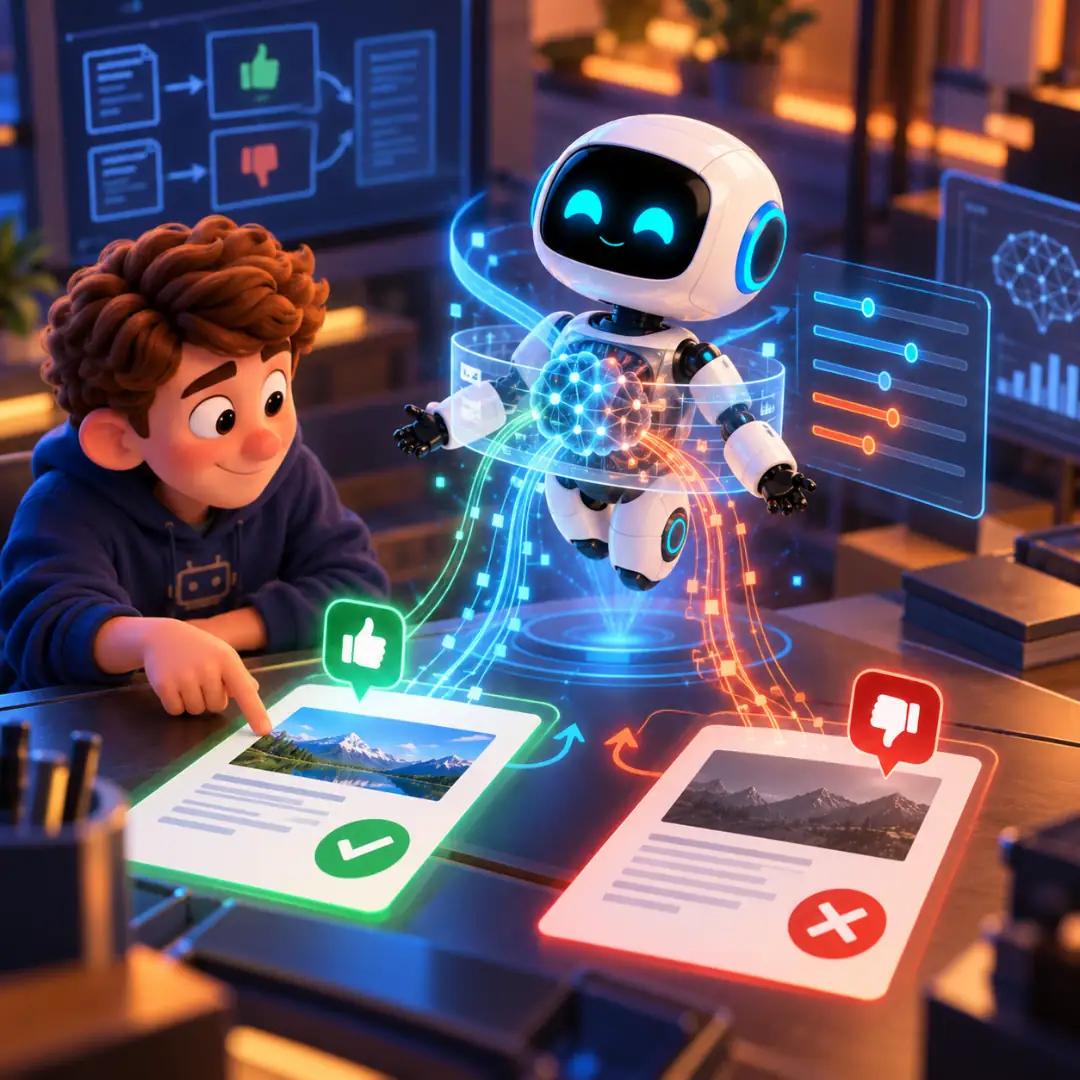 En el enfoque clásico de RLHF, el modelo de recompensa proporciona una señal que el aprendizaje por refuerzo utiliza para ajustar el modelo de lenguaje.
El ajuste modifica los parámetros del modelo y, con ellos, la probabilidad de generar distintas respuestas. No se trata de guardar las respuestas ganadoras para repetirlas, sino de cambiar cómo responde ante nuevas instrucciones.
El límite de aprender a obtener una buena puntuación
Hay un detalle importante: si el modelo de recompensa valora una característica equivocada, el modelo de lenguaje puede aprender a explotarla. Por ejemplo, si las respuestas más largas reciben mejores puntuaciones, podría empezar a extenderse innecesariamente aunque eso no ayude a quien pregunta.
Este comportamiento se conoce como reward hacking: optimizar la recompensa sin alcanzar realmente el objetivo que buscábamos.
RLHF permite orientar el entrenamiento con evaluaciones humanas, pero el resultado depende de cómo se diseñen esas evaluaciones y de que la puntuación refleje lo que de verdad importa. Una respuesta que obtiene una buena recompensa no necesariamente es la mejor respuesta.